เลือกการได้ยินหรือการผลิตเป็นขั้นตอนแรกที่อ่อนแอ
บอก Mocchi ว่าความแตกต่างนั้นฟังยาก พูดยาก หรือแยกง่ายแต่หายไปในประโยค สิ่งเหล่านี้เป็นจุดเริ่มต้นที่แตกต่างกัน การเปรียบเทียบการฟังอาจช่วยได้ก่อนที่จะพยายามบันทึกเสียงอีกครั้ง ในขณะที่ผู้เรียนที่ได้ยินความแตกต่างอาจต้องใช้วลีที่ได้รับการควบคุมและมีเป้าหมายในการจับเวลาที่ชัดเจน ให้เน้นเซสชันแรกไปที่ลิงก์นั้น
ใช้สภาพแวดล้อมที่เงียบสงบและการตั้งค่าการบันทึกที่สอดคล้องกันเมื่อกิจกรรมเกี่ยวข้องกับไมโครโฟน เสียงพื้นหลังหรืออุปกรณ์ที่เปลี่ยนแปลงอาจส่งผลต่อความพยายามและการตอบรับ อย่าคิดว่าผลลัพธ์ที่ไม่คาดคิดทุกครั้งจะเป็นข้อพิสูจน์ถึงข้อผิดพลาดของภาษาใหม่
เปรียบเทียบคู่ที่ชัดเจนโดยไม่ต้องเพิ่มความดังเป็นพิเศษ
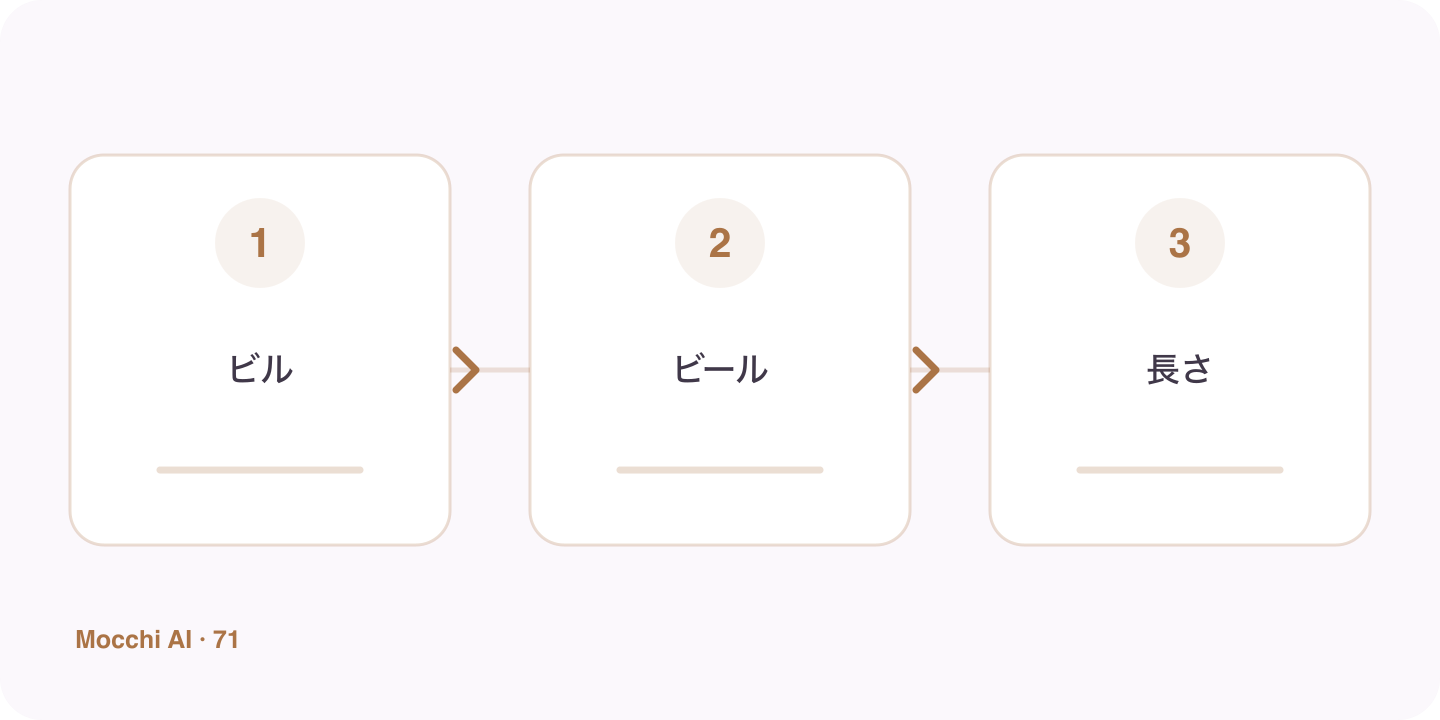
ビル หมายถึงอาคาร ในขณะที่ ビール หมายถึงเบียร์ สระเสียงยาวในคำที่สองบ่งบอกถึงความแตกต่างของเวลาในรูปแบบภาษาญี่ปุ่น อ่านการสะกดคำ ฟังแบบจำลอง และฝึกฝนคำที่ต้องการโดยไม่ต้องเปลี่ยนแบบฝึกหัดเป็นการแข่งขันเพื่อทำให้เสียงหนึ่งดังขึ้น แล้วใช้คำเป็นวลีสั้นๆ ที่มีความหมาย
| ญี่ปุ่น | โรมาจิ | ความหมาย |
|---|---|---|
| 高いビルです。 | Takai biru desu. | มันเป็นอาคารสูง |
| ビールをお願いします。 | Bīru o onegaishimasu. | ขอเบียร์หน่อย |
ใช้บรรทัดที่ให้มาของกิจกรรมการออกเสียง
เมื่อ Mocchi เปิดกิจกรรมการออกเสียงที่ได้รับการฝึกสอน ให้ดำเนินการตามบรรทัดที่อินเทอร์เฟซจัดเตรียมไว้ รับฟัง พยายาม และทำการปรับเปลี่ยนอย่างตั้งใจในแต่ละครั้ง ตัวอย่างในบทความนี้แสดงให้เห็นถึงความแตกต่าง ไม่ใช่การกล่าวอ้างเกี่ยวกับจำนวนบรรทัดหรือคะแนนที่แน่นอนของเซสชันของคุณ อ่านคำติชมจริงก่อนที่จะตัดสินใจว่าจะฝึกฝนอะไรต่อไป
กลับตรงกันข้ามกับวลี
คำที่แยกออกมาอย่างระมัดระวังอาจสั้นลงได้เมื่อความสนใจย้ายไปยังส่วนที่เหลือของประโยค ใช้วลีสั้นๆ ที่คุ้นเคยเพื่อให้เป้าหมายได้ยินเสียงโดยไม่ต้องค้นหาไวยากรณ์ที่ไม่คุ้นเคย หากความแตกต่างหายไป ให้ลดวลีลงสั้นๆ แล้วสร้างใหม่ วิธีนี้จะเชื่อมต่อการเจาะลึกเข้ากับคำพูดที่คุณต้องการใช้
ตรวจสอบการเปลี่ยนแปลงที่เฉพาะเจาะจงมากกว่าตัวเลขเพียงอย่างเดียว
หลังการฝึก ให้อธิบายสิ่งที่คุณปรับและดูว่าคอนทราสต์ชัดเจนขึ้นหรือไม่ในความพยายามอีกครั้ง ใช้คะแนนเมื่อกิจกรรมรายงานจริงเท่านั้น และคำนึงถึงเงื่อนไขของไมโครโฟนด้วย ถาม Mocchi สำหรับเสียงที่มีประโยชน์ถัดไปหรือเซสชันสั้นๆ อื่นตามความเหมาะสม กิจวัตรการออกเสียงส่วนบุคคลพัฒนาขึ้นผ่านการฟังอย่างตั้งใจและความพยายามใหม่ๆ ไม่ใช่โดยถือว่าตัวเลขอัตโนมัติตัวเดียวเป็นการตัดสินที่สมบูรณ์