세 개의 입자
이는 모든 학습자가 직면하는 첫 번째 예외이자 가장 중요한 예외입니다. 관련 세 입자가 거의 모든 문장에 나타나기 때문입니다.
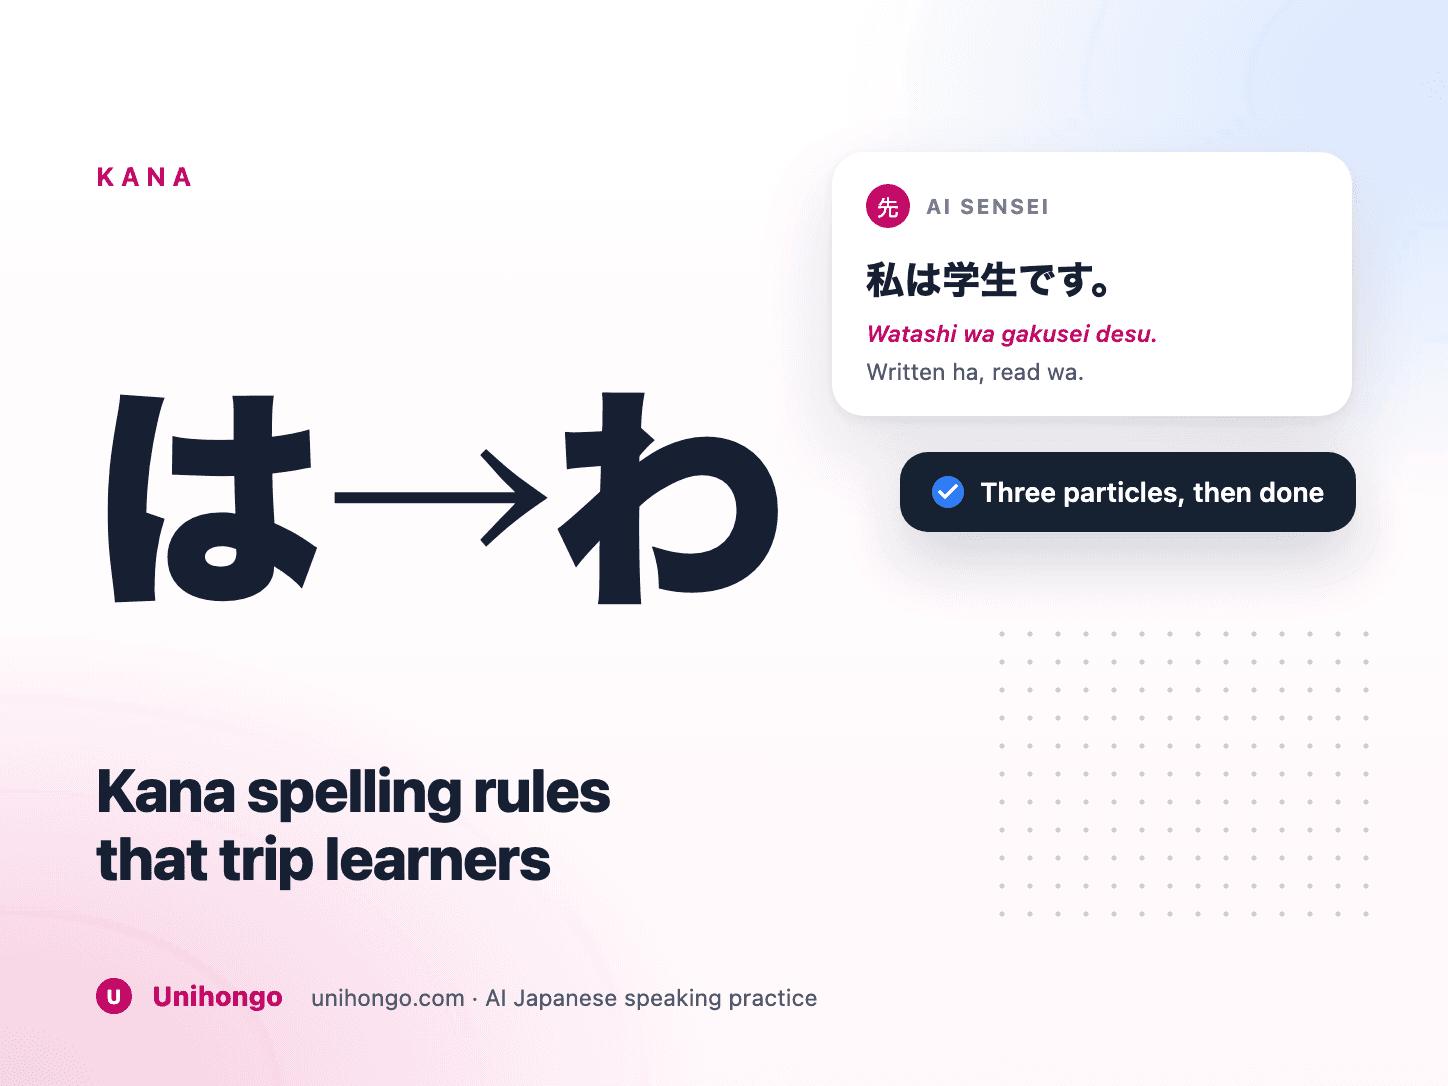
각각의 경우 철자는 오래된 발음을 유지합니다. 규칙은 간단합니다. 문자가 입자로 사용되는 경우 오래된 판독값을 사용합니다. 다른 곳에서는 정상적으로 읽혀집니다.
| 일본어 | 로마자 | 의미 |
|---|---|---|
| は | wa | 입자로서; 그렇지 않으면 읽어보세요 하하 |
| へ | e | 입자로서; 그렇지 않으면 그 사람을 읽어 |
| を | o | 입자로만 사용됨 |
| 私は学生です。 | Watashi wa gakusei desu. | 주제 입자, 읽기 wa |
| 東京へ行きます。 | Tōkyō e ikimasu. | 방향 입자, 읽기 e |
| 本を読みます。 | Hon o yomimasu. | 물체 입자, 읽기 o |
Long o, 두 가지 방식으로 철자됨
긴 o 소리는 u 문자를 추가하거나 o 문자를 추가하여 작성되며, 단어가 취하는 단어는 선택되지 않고 고정되어 있습니다.
u 버전이 훨씬 더 일반적입니다. o가 있는 버전은 더 짧은 단어 목록에 나타나며 그 중 일부는 일상 어휘이므로 세트로 학습할 가치가 있습니다.
| 일본어 | 로마자 | 의미 |
|---|---|---|
| とうきょう | Tōkyō | Long o with u, 일반적인 패턴 |
| おおきい | ōkii | 긴 o와 o: 크다 |
| とおい | tōi | 긴 o와 o: 멀리 |
| おおい | ōi | 긴 o와 o: 많음 |
| とおる | tōru | o와 함께 긴 o: 통과하다 |
| こおり | kōri | 긴 o와 o: 얼음 |
여기서 o로 표기된 다섯 단어는 목록의 상당 부분을 차지합니다. 그룹으로 학습하면 나중에 추측하는 일이 줄어듭니다.
같은 소리를 내는 가나
두 쌍의 유성 가나는 현대 표준 일본어에서 동일하게 발음됩니다. 이는 발음 문제라기보다는 철자 문제이며, 차이점을 들어보려고 노력하는 것은 생산적이지 않습니다.
단어가 사용하는 철자는 고정되어 있습니다. 각 쌍의 덜 일반적인 구성원은 주로 단어가 복합어 내부에서 또는 소수의 설정된 단어에서 표명되는 경우에 나타납니다.
| 쌍 | 발음 | 더 희귀한 것이 나타날 때 |
|---|---|---|
| じ / ぢ | 동일한 | 복합어 및 단어 설정 |
| ず / づ | 동일한 | 복합어 및 단어 설정 |
유용한 경험 법칙: 단어가 두 번째 요소가 무성 문자로 시작하는 합성어인 경우 더 희귀한 철자가 나올 가능성이 높습니다.
긴 e와 긴 i
긴 e는 일반적으로 e 문자 대신 i 문자를 추가하여 작성하는데, 이는 모음이 두 배가 될 것으로 예상하는 학습자를 놀라게 합니다.
Long i는 i 문자를 추가하여 작성되는데, 이는 간단한 경우입니다.
| 일본어 | 로마자 | 의미 |
|---|---|---|
| せんせい | sensei | 긴 e는 i로 쓰여요 |
| えいが | eiga | i로 쓴 긴 e: 영화 |
| とけい | tokei | i로 쓴 긴 e: 시계 |
| おねえさん | onēsan | e로 쓴 긴 e: 언니 |
| おいしい | oishii | 오랫동안 난, 솔직하게 |
| ちいさい | chiisai | 긴 i: 작다 |
예외가 존재하는 이유
모두 같은 출처에서 나온 것입니다. 발음이 다른 점에서 철자가 표준화되었고, 소리가 바뀌어도 글은 따라가지 않았습니다.
이를 아는 것은 언어를 사용하는 데 필수는 아니지만 예외를 임의성이 아닌 역사처럼 느껴지게 하여 더 쉽게 받아들이고 기억할 수 있게 해줍니다.
- 입자 철자는 해당 문자의 오래된 판독값을 보존합니다.
- 중복된 가나 쌍은 한때 별개의 소리였으며 병합되었습니다.
- long o를 쓰는 두 가지 방식은 서로 다른 역사적 기원을 반영합니다.
- 현대 철자법은 20세기에 개혁되어 남아 있는 것보다 더 많은 예외가 제거되었습니다.
실제로 무엇을 배울 것인가
실제 목록은 짧습니다. 세 개의 입자 예외, 하나의 긴 단어 목록, 두 개의 가나 쌍이 동음이의어라는 인식. 그것이 전부입니다.
입자는 모든 문장에 나타나기 때문에 가장 먼저 나오고, 드릴링이 필요 없이 실제 텍스트를 읽은 후 며칠 내에 자동으로 생성됩니다.
그 밖의 모든 것은 만나면서 한 마디씩 배우게 됩니다. 가나는 규칙적이기 때문에 이러한 예외는 눈에 띄고 빠르게 유지됩니다. 이는 그렇지 않은 스크립트보다 거의 음성에 가까운 스크립트의 장점입니다.
이것이 가나에 대한 당신의 신뢰를 흔들리게 하지 마십시오. 대부분의 언어의 철자와 비교할 때 몇 가지 예외는 눈에 띄게 적습니다.